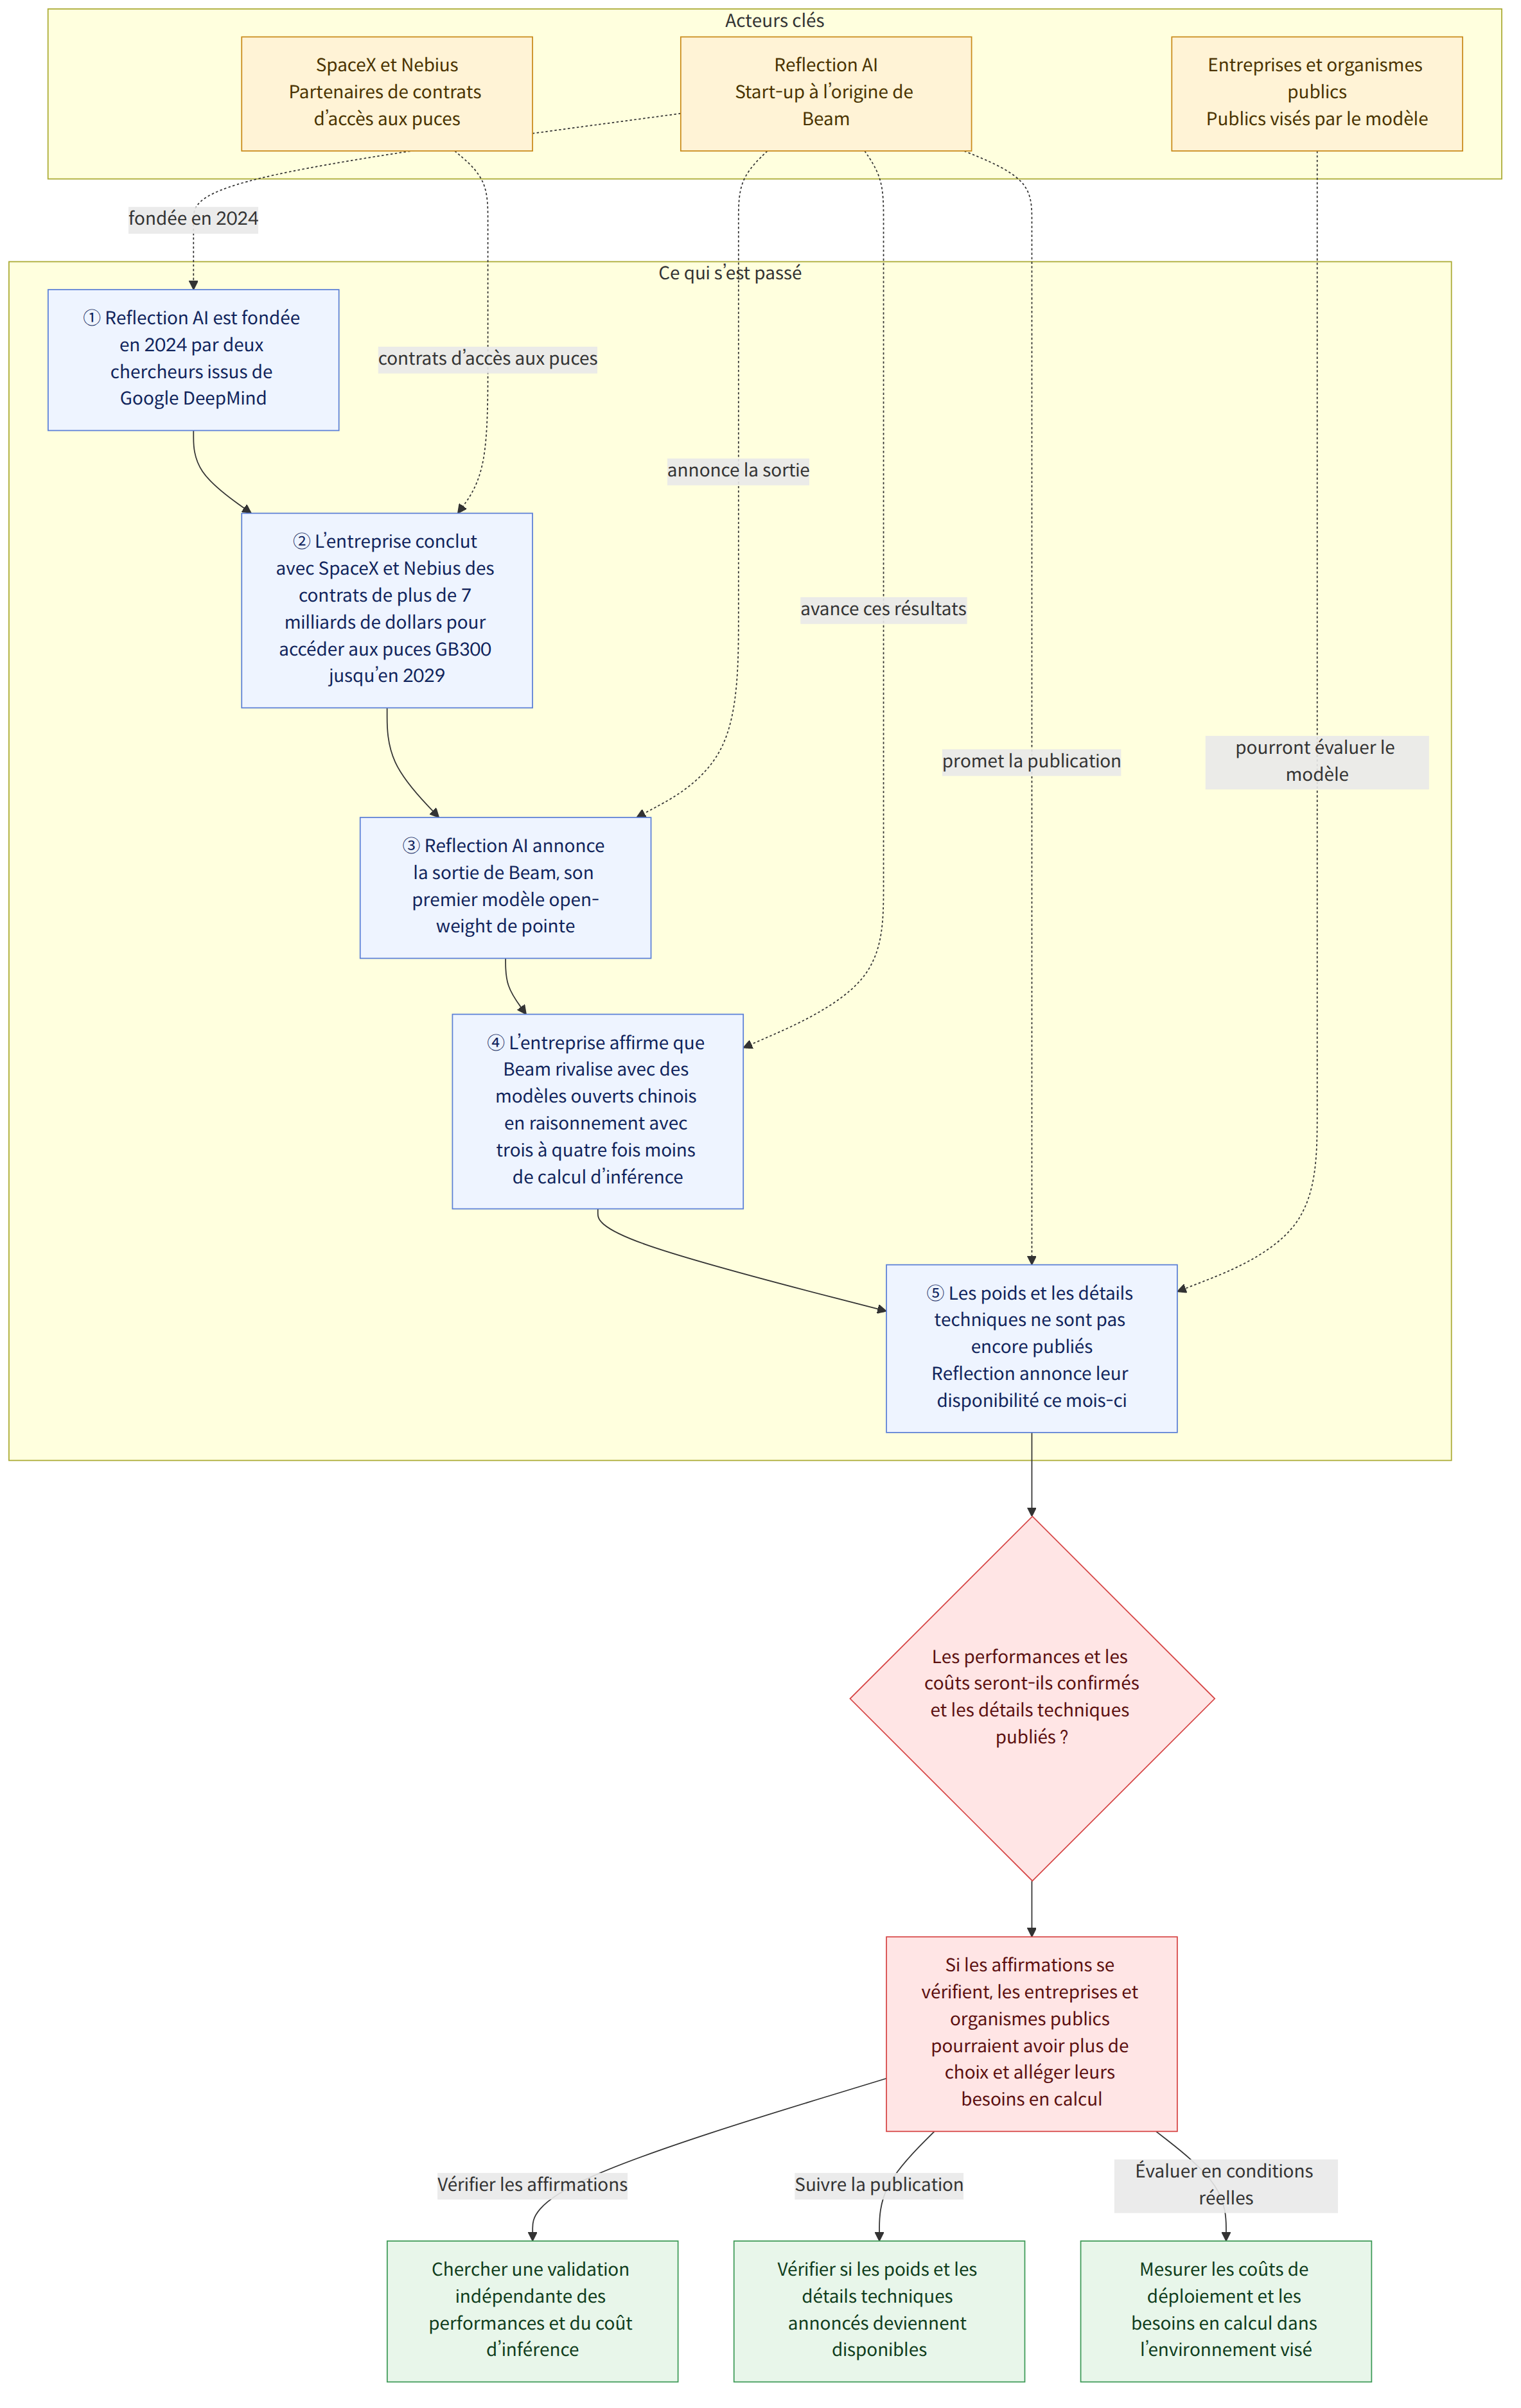
Reflection AI, une start-up basée à Brooklyn qui en est à sa deuxième année d’existence, a annoncé la sortie de son premier modèle d’IA open-weight de pointe, Beam. L’open-weight consiste à rendre publics les poids du modèle — les valeurs numériques internes déterminées par l’entraînement — afin qu’il puisse être utilisé par des tiers. Reflection affirme que Beam obtient des performances comparables à celles des principaux modèles ouverts chinois sur les benchmarks avancés de raisonnement, tout en nécessitant beaucoup moins de calcul d’inférence. Ces affirmations sur les performances et les coûts n’ont toutefois pas été vérifiées de manière indépendante.
Contexte
D’après les informations publiées par Reflection, Beam est un modèle exclusivement textuel reposant sur un mélange d’experts (MoE). Cette architecture fait appel à une partie seulement de plusieurs sous-modèles spécialisés pour traiter les requêtes. L’entreprise explique avoir entraîné le modèle par apprentissage par renforcement nécessitant d’importantes capacités de calcul, afin d’obtenir de bons résultats en raisonnement, en programmation et dans les tâches agentiques.
Beam est un modèle comptant 501 milliards de paramètres au total, dont 23 milliards sont activés. Son préentraînement a utilisé 23 800 milliards de tokens et sa fenêtre de contexte — la quantité d’informations qu’il peut prendre en compte en une seule fois — est d’un million de tokens. À titre de comparaison, le GLM-5.2 de Z.ai compte environ 744 milliards de paramètres au total, dont 40 milliards de paramètres actifs.
Reflection affirme que Beam obtient des résultats équivalents à ceux du GLM-5.2 sur les benchmarks avancés de raisonnement et qu’il surpasse actuellement les principaux modèles open-weight occidentaux, tout en utilisant trois à quatre fois moins de calcul d’inférence. Dans une autre comparaison présentée par l’entreprise, Beam a obtenu de meilleurs scores qu’Inkling lors de quatre tests de programmation pour lesquels les deux modèles ont publié leurs résultats. Inkling est toutefois un modèle multimodal — qui traite plusieurs types d’informations au-delà du texte —, tandis que Beam est exclusivement textuel : leurs usages et les types d’entrées qu’ils peuvent traiter ne sont donc pas identiques.
Les affirmations de Beam concernant ses performances et son coût d’inférence n’ont pas encore été vérifiées de manière indépendante. Les résultats de benchmarks présentés par l’entreprise ne suffisent pas à établir ses performances ni ses coûts dans des services réels.
Reflection présente Beam comme un « modèle polyvalent » destiné aux entreprises, au secteur public et aux développeurs. Cette sortie s’inscrit dans le projet de l’entreprise de proposer un modèle occidental capable de rivaliser avec les modèles ouverts chinois. Toutefois, les poids et l’ensemble des détails techniques — des éléments essentiels pour évaluer les performances du modèle — n’ont pas encore été publiés ; l’entreprise a annoncé qu’elle les rendrait disponibles ce mois-ci.
Reflection a été fondée en 2024 par deux chercheurs issus de Google DeepMind. Selon PitchBook, l’entreprise a levé environ 4,7 milliards de dollars auprès d’investisseurs, parmi lesquels Nvidia, Sequoia Capital et Lightspeed Venture Partners. Lors de son dernier tour de financement, sa valorisation avant investissement s’élevait à 25 milliards de dollars. Cet été, l’entreprise a conclu avec SpaceX et Nebius des contrats d’un montant total supérieur à 7 milliards de dollars, qui lui donneront accès aux puces GB300 de Nvidia jusqu’en 2029.
Ce que cela signifie
Si les affirmations concernant l’open-weight de Beam et son faible coût d’inférence se vérifient, les entreprises et les organismes publics souhaitant utiliser directement des modèles pourraient disposer d’un plus grand choix. Le projet d’« usines d’IA » de Reflection vise notamment à permettre aux institutions d’entraîner des modèles Reflection avec leurs propres données propriétaires afin de créer des systèmes d’IA locaux sur mesure. Si le coût d’utilisation des modèles ou les besoins en calcul diminuent, cela pourrait alléger la charge des institutions qui envisagent de tels systèmes. Il s’agit toutefois d’un effet potentiel, et non d’un résultat établi : il dépend de la validation des affirmations de l’entreprise sur les coûts.
Par exemple, une institution qui envisage un système d’IA exploitant ses propres données pourrait, après la publication des poids et de la documentation technique de Beam, évaluer les performances et les besoins en calcul dans son environnement. Mais les coûts réels de déploiement et les conditions de mise en œuvre n’ont pas été publiés. On ne peut donc pas conclure que l’affirmation selon laquelle Beam « utilise moins de calcul » se traduira automatiquement par une baisse des coûts de déploiement.
Reflection a commencé à tester un projet de partenariat avec le groupe Shinsegae autour d’une usine d’IA souveraine. Selon Axios, des fonds spéculatifs et des sociétés de trading ont également manifesté leur intérêt pour la création de tels systèmes. L’entreprise ayant annoncé qu’elle publierait ce mois-ci les poids de Beam et l’ensemble des détails techniques, et qu’elle proposerait dès le lancement un déploiement par l’intermédiaire d’hyperscalers et de néoclouds ainsi qu’une intégration aux bibliothèques open source, il faudra suivre de près les institutions qui pourront effectivement l’utiliser et les modalités de cet accès.
Ce qui est établi et ce qui reste à savoir
Faits établis
- Reflection a annoncé la sortie de son premier modèle open-weight de pointe, Beam.
- Beam est un modèle exclusivement textuel qui compte 501 milliards de paramètres au total, dont 23 milliards de paramètres actifs.
- Le modèle a été préentraîné avec 23 800 milliards de tokens et possède une fenêtre de contexte d’un million de tokens.
- L’entreprise a commencé à tester un projet de partenariat avec le groupe Shinsegae autour d’une usine d’IA souveraine.
Ce qui reste à savoir
- On ne sait pas encore comment les affirmations de Beam sur ses performances et son coût d’inférence résisteront à une vérification indépendante.
- La date exacte de publication des poids et de la documentation technique, annoncée pour ce mois-ci, n’a pas été précisée.
- Aucun détail concret n’a été communiqué sur la manière dont les essais avec le groupe Shinsegae se dérouleront.
- Le prix d’utilisation réel de Beam et ses conditions de déploiement n’ont pas été révélés.
Ce que les lecteurs peuvent surveiller
- Les entreprises et les développeurs qui souhaitent évaluer le modèle devront, après la publication de ses poids et de la documentation technique, examiner les conditions des benchmarks, les critères de comparaison du calcul d’inférence et les résultats correspondant à leurs propres tâches.
- Les institutions qui envisagent de l’adopter devront vérifier non seulement si le déploiement par des hyperscalers ou des néoclouds est possible, mais aussi si les prix réels et les conditions d’utilisation sont publiés.
- Les institutions intéressées par des systèmes d’IA utilisant leurs propres données pourront suivre les modalités et le périmètre d’application qui seront communiqués dans le cadre du projet d’essai avec le groupe Shinsegae.