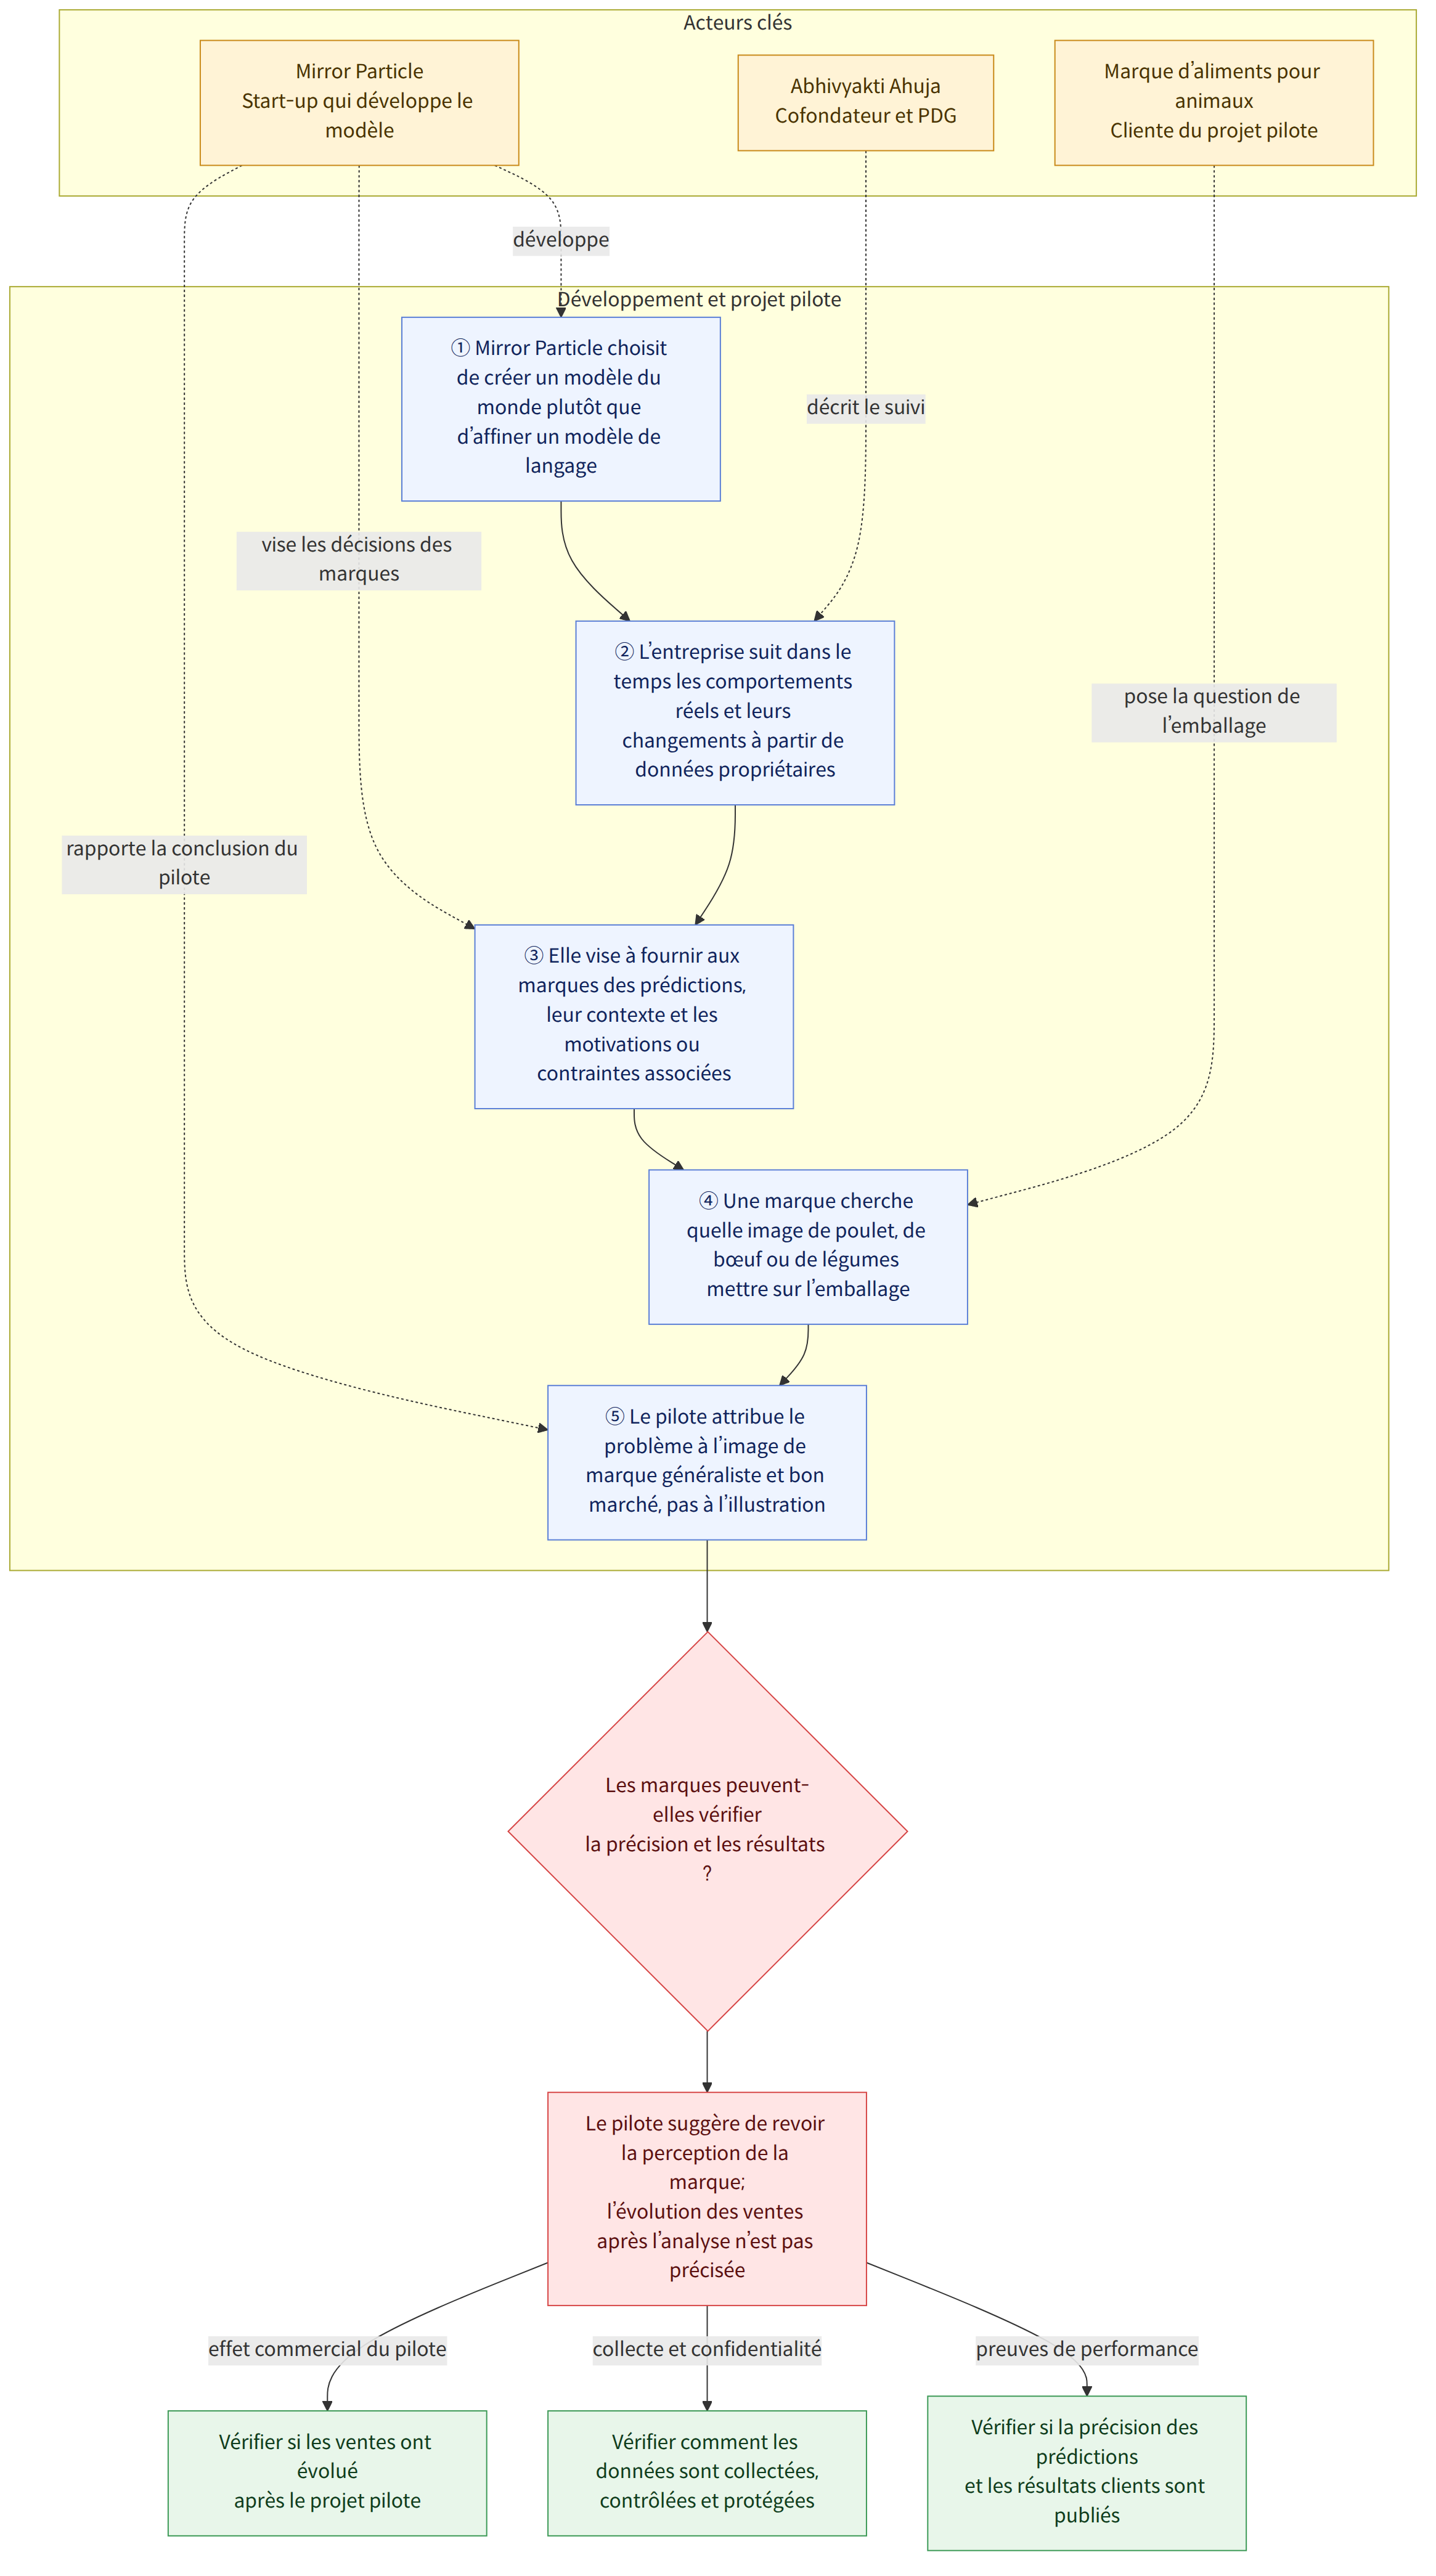
La start-up Mirror Particle, basée à San Francisco, développe un moteur d’IA destiné aux marques pour prédire les comportements des consommateurs et leurs raisons, ainsi que son propre « modèle du monde ». Son cofondateur et PDG, Abhivyakti Ahuja, affirme que les grands modèles de langage — des IA qui traitent le langage après avoir été entraînées sur de vastes volumes de texte — ont des limites fondamentales lorsqu’il s’agit de prédire le comportement humain. Plutôt que d’affiner un modèle de langage, l’entreprise entend construire de zéro un modèle de fondation — un modèle d’IA conçu pour servir à diverses fins — qui simule dans le temps ce que font les humains et les raisons pour lesquelles ils changent de comportement.
Contexte
Les investissements et les lancements de produits se multiplient dans les entreprises d’IA qui cherchent à prédire les comportements humains. Selon l’article, Simile a levé 200 millions de dollars au cours de l’année écoulée, pour une valorisation de 2 milliards de dollars, et Aru a levé 88 millions de dollars, pour une valorisation d’un milliard de dollars. En janvier, Humans& a annoncé un tour de table d’amorçage de 480 millions de dollars, pour une valorisation de 4,48 milliards de dollars, avant de lancer Persimmon, un produit de modélisation du comportement humain.
Dans ces exemples, la question de la manière et des données à partir desquelles représenter les êtres humains constitue un enjeu concurrentiel notable. Ahuja estime que les approches existantes s’appuient sur de grands modèles de langage auxquels on attribue le rôle d’un groupe démographique donné ou que l’on entraîne davantage, mais que le langage sur lequel ces modèles ont principalement été entraînés n’équivaut pas à la perception humaine réelle, à la compréhension de l’espace ou à l’intelligence sociale. Il s’agit d’une critique formulée par l’entreprise ; l’article ne présente pas de comparaison directe des performances des modèles de langage existants et de ceux de Mirror Particle.
Mirror Particle explique modéliser les personnes non comme un ensemble de caractéristiques fixes, mais comme des êtres qui évoluent au fil de leurs expériences. Selon Ahuja, l’entreprise suit, à l’aide de données longitudinales — des données recueillies au fil du temps auprès des mêmes individus ou groupes — la manière dont les gens changent, ce qui déclenche ces changements et leur ampleur. L’absence de changement est également considérée comme un signal, précise-t-il.
Les données propriétaires utilisées par l’entreprise comprennent des données clients ainsi que des contenus liés à l’actualité, à la culture populaire et aux réseaux sociaux. L’entreprise les combine pour modéliser des groupes démographiques et se concentre sur ce que les gens ont réellement fait, autrement dit les « comportements révélés », plutôt que sur ce qu’ils déclarent dans des sondages. L’article ne précise toutefois ni le volume exact des données, ni leurs modalités de collecte et de vérification, ni les mesures prises pour protéger les informations personnelles.
Ce que signifie cette annonce
La différence que met en avant Mirror Particle tient au fait qu’elle fournit aux clients non seulement des prédictions de comportement, mais aussi le contexte des recommandations, ainsi que les motivations et les contraintes qui sous-tendent ces comportements. L’idée est d’aider les marques à aller au-delà de la question de savoir ce que choisira tel consommateur, en examinant les facteurs qui orientent ce choix ou y font obstacle, afin de les intégrer à leurs décisions. Pour conquérir ses premiers clients, l’entreprise se concentre sur des domaines qui disposent déjà de budgets pertinents, comme les études de marché et les stratégies de marque et de produit.
Un exemple de projet pilote permet de voir comment cette approche pourrait être utilisée. Une grande marque d’aliments pour animaux de compagnie cherchait à savoir quelle image — de poulet, de bœuf ou de légumes — apposer sur son emballage pour augmenter ses ventes. Mirror Particle a estimé que le problème ne venait pas de l’image, mais de la perception de la marque comme généraliste et bon marché, et que les ventes risquaient de stagner si cette perception ne changeait pas. Il s’agit du résultat d’un projet pilote rapporté par l’entreprise ; l’article ne précise pas comment les ventes ont évolué après cette analyse.
Par exemple, si une marque hésite sur l’image à utiliser dans une publicité pour un produit donné, cette approche pourrait chercher non seulement à connaître les préférences en matière d’images, mais aussi à déterminer si le groupe cible désire le produit lui-même et s’il existe des perceptions ou des contraintes qui freinent son achat. On ne peut toutefois pas affirmer qu’une telle analyse améliore les ventes. L’article ne fournit aucun chiffre permettant d’évaluer la précision des prédictions du modèle de Mirror Particle ou les résultats obtenus par ses clients.
Ahuja a déclaré que le modèle évoluerait à la manière d’un bébé qui découvre le monde, de la vision au langage, à la conscience corporelle et à l’intelligence sociale. À long terme, l’entreprise ambitionne de passer de l’analyse de larges groupes démographiques à des observations au niveau individuel, pour devenir un modèle général de prédiction du comportement humain. Il s’agit de l’orientation annoncée par l’entreprise, et non de la preuve qu’une fonction de prédiction individuelle est déjà opérationnelle.
Faits établis et inconnues
Faits établis
- Mirror Particle est une start-up dans sa deuxième année d’existence qui fournit aux marques un moteur d’IA destiné à prédire les comportements des consommateurs et leurs raisons.
- L’entreprise explique combiner des données clients avec des contenus liés à l’actualité, à la culture populaire et aux réseaux sociaux, et privilégier les comportements réels plutôt que les réponses aux sondages.
- Dans un projet pilote initial, elle a attribué la stagnation des ventes d’une marque d’aliments pour animaux de compagnie à la perception de la marque, et non à l’image figurant sur l’emballage.
- L’entreprise a déclaré avoir levé un tour de table auprès d’investisseurs providentiels et être sur le point de clôturer son premier tour de financement en capital-risque.
- L’article indique qu’elle doit participer la semaine prochaine au Startup Battlefield 200 de TechCrunch Disrupt, qui se tiendra à San Francisco du 13 au 15 octobre 2026.
Inconnues à ce stade
- Le montant du tour de table auprès des investisseurs providentiels et l’identité des investisseurs n’ont pas été dévoilés.
- Le montant et les conditions définitives du premier tour de financement en capital-risque, que l’entreprise dit proche de clôturer, ne sont pas connus.
- L’article ne permet pas de connaître la précision des prédictions du modèle, les résultats de comparaisons avec les méthodes existantes ou les résultats concrets obtenus par les clients.
- Les sources précises des données ainsi que les modalités de leur traitement et de leur protection ne sont pas indiquées.
Points à vérifier
- Si vous envisagez d’utiliser un tel outil pour une stratégie de marque ou de produit, il est utile d’examiner non seulement les recommandations, mais aussi les données comportementales qui les étayent et les explications concernant les motivations et les contraintes.
- Étant donné que, selon l’hypothèse de l’entreprise, les réponses aux sondages peuvent différer des comportements réels, vous pouvez demander sur quelles données et quelles procédures de validation reposent les prédictions.
- Concernant les levées de fonds, les seules informations confirmées sont les déclarations de l’entreprise selon lesquelles elle a levé un tour auprès d’investisseurs providentiels et approche de la clôture de son premier tour de financement en capital-risque. Il convient de vérifier si le montant et les conditions détaillés ont été rendus publics séparément.