La startup Mirror Particle, con sede a San Francisco, fornisce ai brand un motore di IA che prevede i comportamenti dei consumatori e le loro motivazioni, e sta sviluppando un proprio «modello del mondo». Il cofondatore e CEO Abhibhyakti Ahuja sostiene che i modelli linguistici di grandi dimensioni (IA che elaborano il linguaggio dopo aver appreso da enormi quantità di testo) presentino limiti fondamentali nel prevedere il comportamento umano. Invece di mettere a punto modelli linguistici, l’azienda punta a costruire da zero un modello di base (un modello di IA progettato per essere utilizzato in diversi ambiti) che simuli nel tempo che cosa fanno le persone e perché cambiano comportamento.
Contesto e quadro generale
Le aziende di IA che cercano di prevedere il comportamento umano continuano ad attirare investimenti e a lanciare prodotti. Secondo l’articolo, nell’ultimo anno Simile ha raccolto 200 milioni di dollari con una valutazione di 2 miliardi di dollari, mentre Aru ha raccolto 88 milioni di dollari con una valutazione di 1 miliardo di dollari. A gennaio, Humans& ha annunciato un round seed da 480 milioni di dollari, con una valutazione di 4,48 miliardi di dollari, e in seguito ha lanciato Persimmon, un prodotto per la modellazione del comportamento umano.
Insieme a questi casi, un tema centrale della competizione è come rappresentare le persone e con quali dati. Ahuja ritiene che gli approcci esistenti facciano affidamento su modelli linguistici di grandi dimensioni ai quali viene assegnato il ruolo di un particolare gruppo demografico o che vengono ulteriormente addestrati, ma sostiene che il linguaggio su cui i modelli hanno appreso non equivalga alla percezione, alla comprensione spaziale e all’intelligenza sociale reali degli esseri umani. Si tratta di una critica sollevata dall’azienda; l’articolo non presenta risultati di un confronto diretto tra i modelli linguistici esistenti e quelli di Mirror Particle.
Mirror Particle spiega di modellare le persone non come insiemi di caratteristiche fisse, ma come individui che cambiano in base alle esperienze. Secondo Ahuja, l’azienda segue con dati longitudinali (dati raccolti osservando nel tempo gli stessi soggetti o gruppi) come cambiano le persone, che cosa innesca il cambiamento e in quale misura. Anche l’assenza di cambiamenti, spiega, viene considerata un segnale.
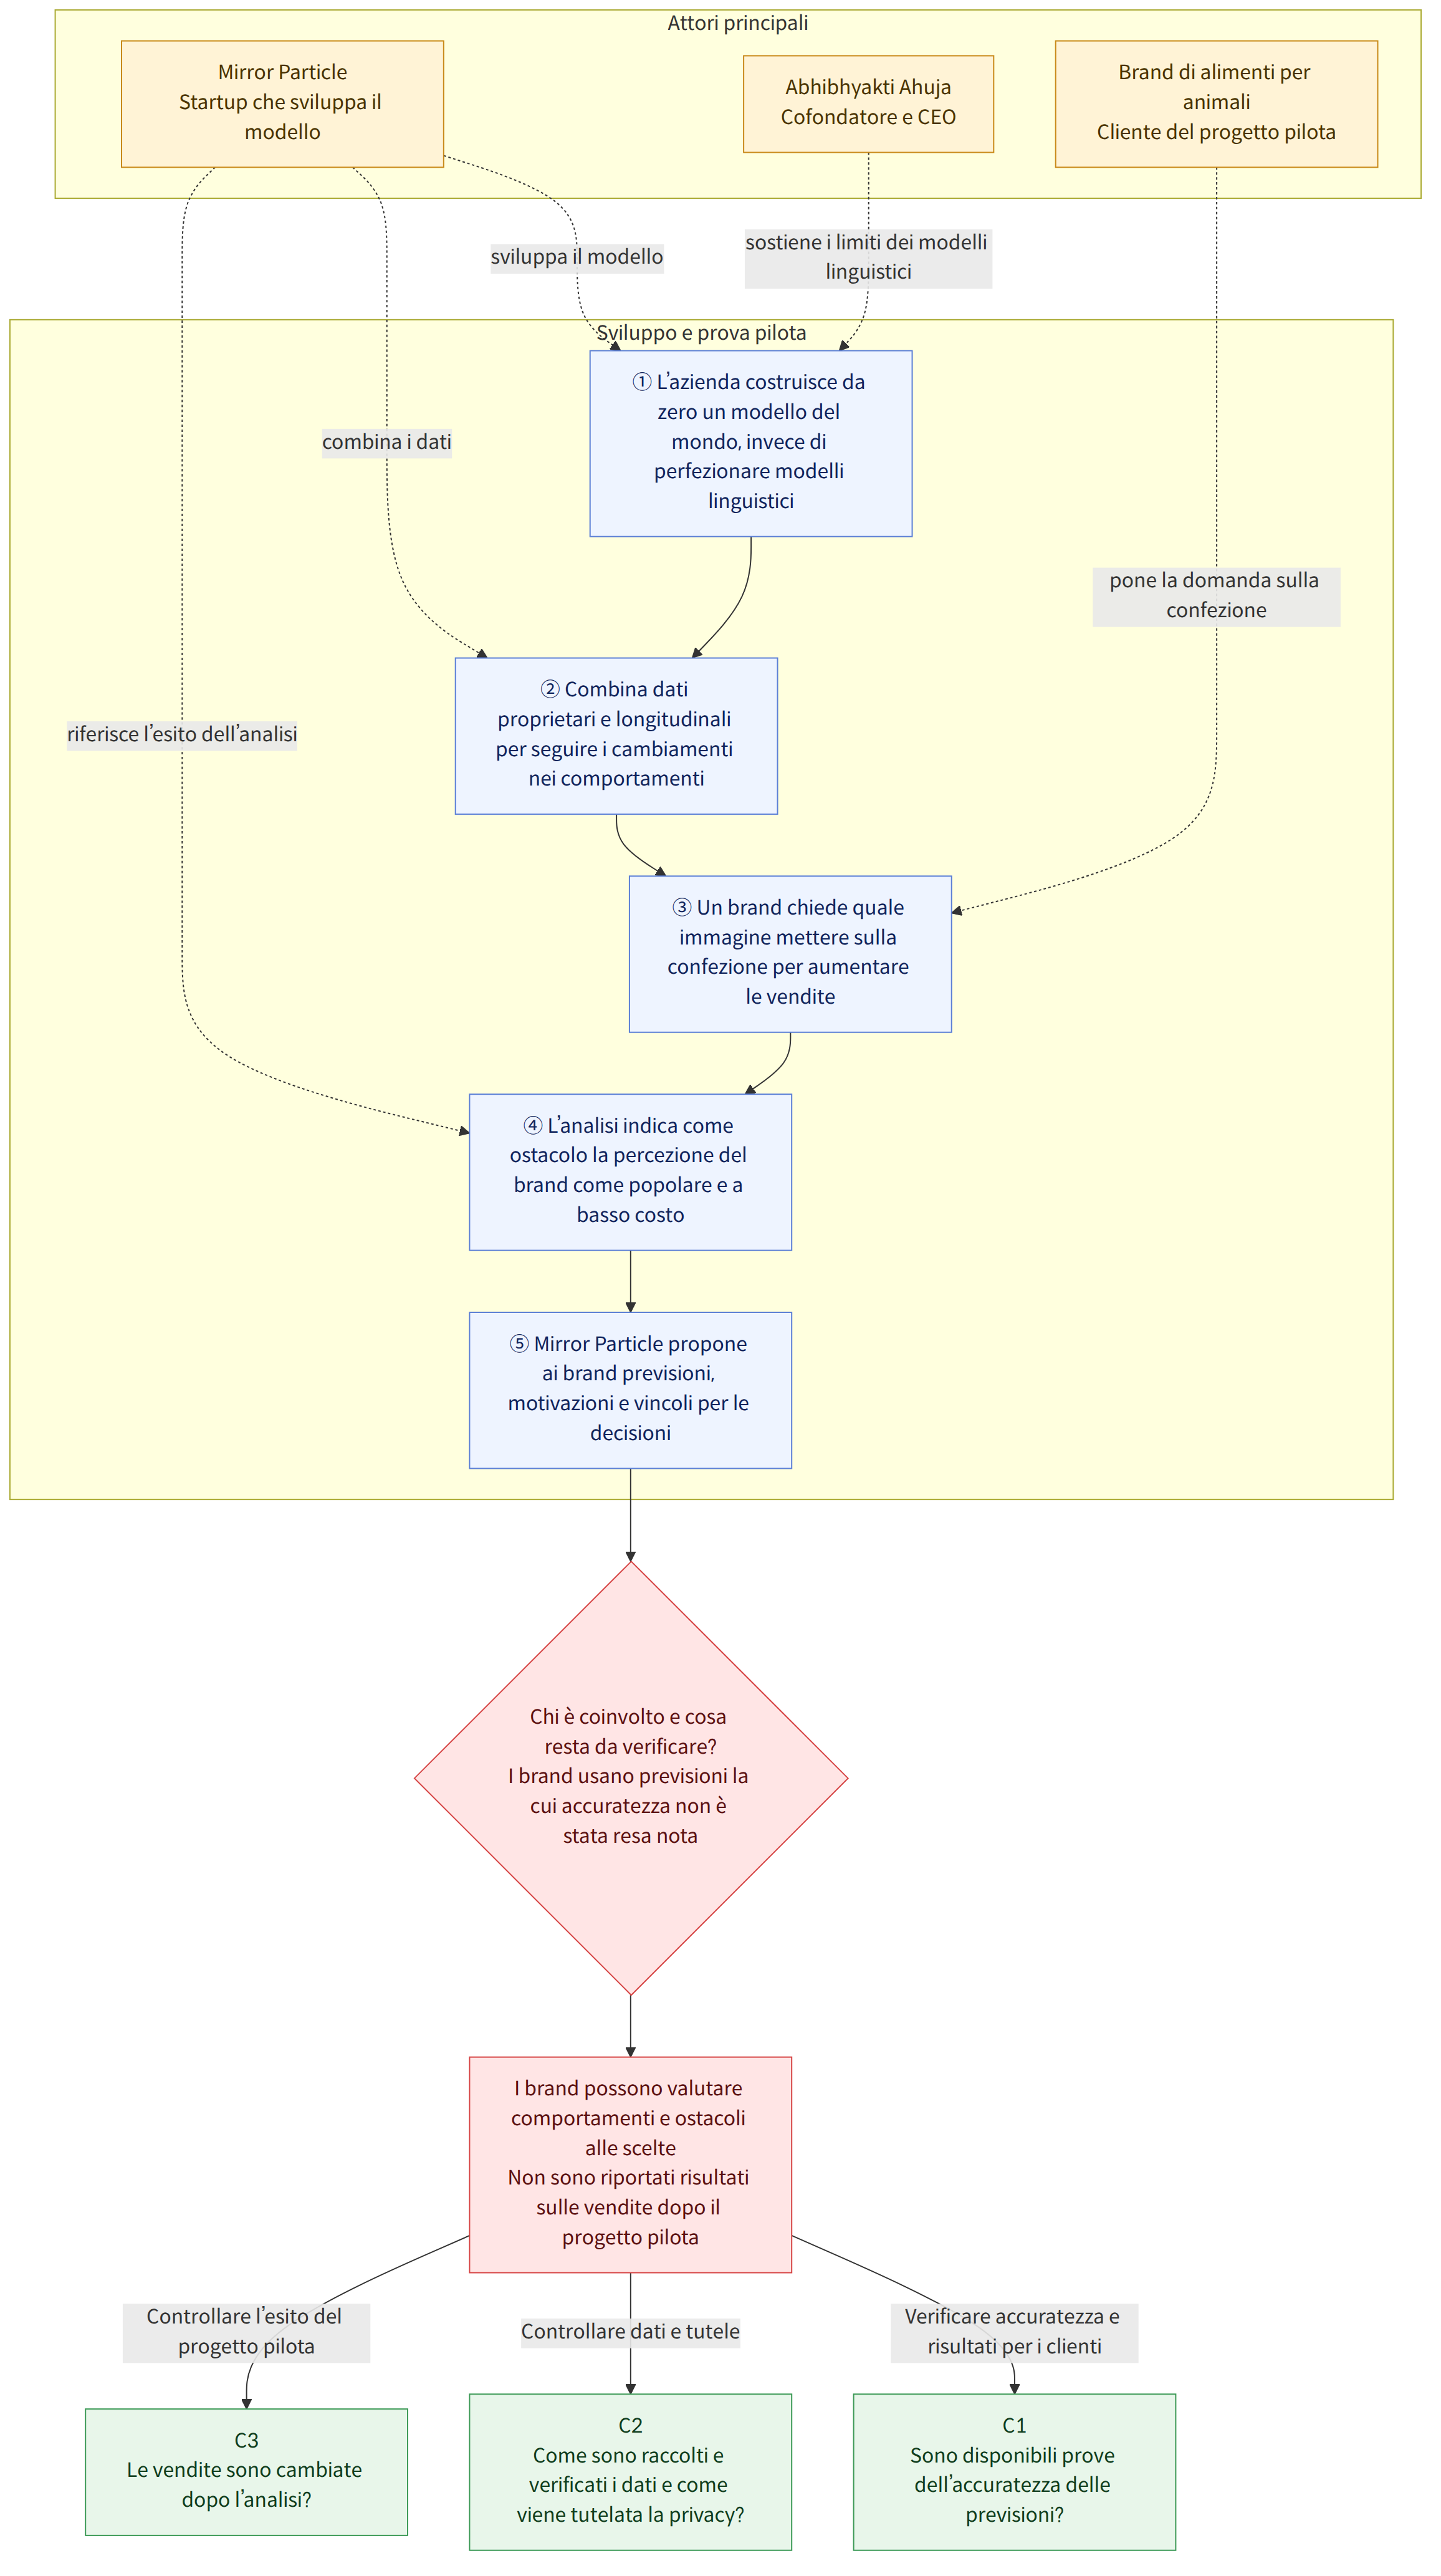
I dati proprietari utilizzati dall’azienda comprendono dati dei clienti, attualità, cultura pop e social media. L’azienda li combina per modellare specifici gruppi demografici e si concentra sui comportamenti effettivi delle persone, cioè sui «comportamenti rivelati», anziché su ciò che dichiarano nei sondaggi. L’articolo, tuttavia, non specifica le dimensioni dei dati, le modalità di raccolta e verifica né le procedure di tutela della privacy.
Che cosa significa questa notizia
La differenza che Mirror Particle rivendica consiste nel fornire ai clienti non solo previsioni sui comportamenti, ma anche le motivazioni e i vincoli che li determinano, oltre al contesto delle raccomandazioni. L’idea è aiutare i brand ad andare oltre la domanda su che cosa sceglierà un consumatore e a esaminare i fattori che ostacolano o favoriscono quella scelta, affinché possano tenerne conto nelle proprie decisioni. Per acquisire i primi clienti, l’azienda si concentra su settori che dispongono già di budget pertinenti, come le ricerche di mercato e le strategie di brand e di prodotto.
Un caso iniziale di prova mostra come potrebbe essere utilizzato questo approccio. Un noto brand di alimenti per animali ha chiesto quale immagine — pollo, manzo o verdure — inserire sulla confezione per aumentare le vendite. Mirror Particle ha concluso che il problema non era l’immagine, ma la percezione del brand come popolare e a basso costo, e che le vendite avrebbero potuto ristagnare se tale percezione non fosse cambiata. È il risultato di un progetto pilota riferito dall’azienda; l’articolo non indica come siano effettivamente cambiate le vendite dopo quell’analisi.
Per esempio, se un brand deve scegliere l’immagine da usare nella pubblicità di un prodotto, questo approccio potrebbe cercare di capire, invece di limitarsi a chiedere quale immagine piaccia di più, se il gruppo a cui si rivolge desideri il prodotto stesso e se vi siano percezioni o vincoli che ne ostacolano l’acquisto. Non si può tuttavia affermare che un’analisi del genere migliori effettivamente le vendite. L’articolo non fornisce dati che consentano di verificare l’accuratezza delle previsioni del modello di Mirror Particle o i risultati ottenuti dai clienti.
Ahuja ha dichiarato che il modello si svilupperà come un bambino, imparando a conoscere il mondo attraverso la vista, il linguaggio, la consapevolezza del proprio corpo e l’intelligenza sociale. La visione di lungo periodo dell’azienda è passare dall’analisi di ampi gruppi demografici a intuizioni a livello individuale e diventare una base generale per prevedere il comportamento umano. Si tratta della direzione indicata dall’azienda, non significa che oggi sia già disponibile una funzionalità di previsione individuale.
Fatti accertati e aspetti ancora da chiarire
Fatti accertati
- Mirror Particle è una startup al suo secondo anno di attività e fornisce ai brand un motore di IA che prevede i comportamenti dei consumatori e le loro motivazioni.
- L’azienda spiega di combinare dati dei clienti con attualità, cultura pop e social media, concentrandosi sui comportamenti reali più che sulle risposte ai sondaggi.
- In un progetto pilota iniziale, ha attribuito il ristagno delle vendite di un brand di alimenti per animali alla percezione del brand, anziché all’immagine sulla confezione.
- L’azienda ha dichiarato di aver raccolto un round angel e di essere prossima a chiudere il suo primo round di venture capital.
- L’articolo afferma che la settimana successiva l’azienda avrebbe partecipato allo Startup Battlefield 200 di TechCrunch Disrupt, in programma a San Francisco dal 13 al 15 ottobre 2026.
Aspetti ancora da chiarire
- Non sono stati resi noti né l’importo del round angel né i nomi degli investitori.
- Non si conoscono l’entità e le condizioni finali del primo round di venture capital, che l’azienda ha dichiarato essere vicino alla chiusura.
- L’articolo non consente di verificare l’accuratezza delle previsioni del modello, i risultati del confronto con gli approcci esistenti o i risultati effettivi ottenuti dai clienti.
- Non vengono specificate le fonti concrete dei dati né le modalità di trattamento e protezione.
Che cosa dovrebbe verificare il lettore
- Se si sta valutando uno strumento del genere per le strategie di brand o di prodotto, è opportuno esaminare non solo le raccomandazioni, ma anche i dati comportamentali su cui si basano e le spiegazioni relative a motivazioni e vincoli.
- Considerando la premessa dell’azienda secondo cui le risposte ai sondaggi possono differire dai comportamenti reali, si può chiedere su quali dati e procedure di verifica si fondino le previsioni.
- Le informazioni sugli investimenti confermano quanto dichiarato dall’azienda: la raccolta di un round angel e l’imminente chiusura del primo round di venture capital. Occorre verificare se importo e condizioni specifiche siano stati resi noti separatamente.